テスト自体を評価する
このお題の「テスト」が中学校のテストなのか資格試験なのかはわからないが、共通して使えるコツが自分の中にあるので紹介する。
タイトルにもある通り、テスト自体を評価してみるといい。具体的には、試験の過去問を扱う参考書(赤本など)の初めのほうにある、試験自体の講評のような部分を自分なりに書いてみることである。たとえば、「○○年度から昨年度までは傾向や問題構成に大きな変化はない...」といった具合にである。それに加えて、扱うテストの範囲から簡単な分野と難しい分野に分類する(客観的ではなく、主観的に)。そして、勉強して得点に直結しそうな分野もランク分けしてみる。
こういった具合にテスト自体を評価していくと、テスト勉強をする際に、どの分野の問題を重点的に解くべきかがわかってくる。テストまでの時間は限られている。テスト範囲全体をまんべんなくやるのは、思考停止とほぼ同じだ。
さらに具体的に説明する。中学校の数学のテストで、平方根と二次関数がテストに出るとなったときに、見切り発車で問題集を解き始めるのは効率が悪いと誰もが感じるであろう。まず、自分は平方根や二次関数について現在どれだけで理解できていて、どれくらいのレベルの問題をどれくらいの正確性で解くことができるのか、テストではどれくらいの難易度の問題が出題されるのか、その教師の作るテストにはどのような傾向があるのか、といった要素をまず書き出してみるといい。そのうえで、自分が重点的にやるべき分野を選定するという作業が、そもそもテスト勉強を始める以前に不可欠である。
苦手な分野を重点的に勉強するというのも微妙である。そもそもその分野の問題がどれくらいの配点で出題されるのか考慮しているのか微妙だし、テスト本番までに仕上がるかも微妙だし、その分野以外の勉強時間を削ることによって生じうるミスを考慮しているのかもわからない。
結論として、結局何が言いたいかというと、どんなテストであれ、まずテスト勉強を始める前に自分の立ち位置とすべきことを明確にしようということである。学生であれば、これからも多くの試験を経験するはずなので、毎度テスト勉強のスタート時点での記録をテストに対する自分なりの評価という形でまとめておこう。テストが終わった後に、自分のテスト勉強のどこが良くてどこが悪かったのか、いくらかは落ち着いて分析できるはずだ。
勉強を集中して続ける方法(受験勉強や資格取得に)
ちょうど集中力が切れて、はてなブログをサーフィンしてたら面白そうなお題があったので書いてみます。
集中力が途切れた時には
多分このお題は、ある作業に取り組んでいて、もう少し頑張って続けないといけないけど集中できない!っていう文脈だと想定して回答します。
まずやらないことを挙げるとしたら、
SNS, YouTube, 漫画 を見ること
で、言うまでもなく私の一日のスケジュールが崩壊するのでだめです(理性の強い人であれば別ですが)。
その上で私がお勧めしたいのは(受験期とかで実践したのは)、
1. 散歩 or ランニング
少し体が疲れるくらいやって、家に戻ったら次は脳にバトンタッチだ(?)
2. やる気の出る伝記とかを読む
受験期のころに、学年ビリのギャルが1年で偏差値を40上げて慶應大学に現役合格した話[文庫特別版] (角川文庫) をやる気が出ないときにずっと読んでました。おすすめです。頑張る勇気をもらえます。
3. 「いつやるの、今でしょ」と自問自答
結局、いろいろ試行錯誤した結果、行き着く先は精神論です。某有名予備校の先生のセリフは、まさにそういうことを意味していると私は勝手に解釈しています。
駆け出しはてなブロガーとして
ブロガーとしては、集中力が途切れた時にはブログを書くというのがおそらく正解なのかもしれませんね笑。
あるいは、ブログを書きすぎて集中力が切れたなんて状況になったら一人前のブロガーなのかな、という感想でこのお題への回答を締めくくりたいと思います。
以上、集中力が途切れた時に書いたブログでした。
読んでいただきありがとうございます。
gitの基本的なコマンド (add, branch, switch, merge, commit, push)
gitの基本的なコマンド
初めにやる操作
git init
git add -A
git status
git commit -m "initinal commit"

git remote add <name> <url>
git branch -M main
git push -u origin main
git init: gitレポジトリを初期化
git add -A: ファイルの変更(追加、編集、削除) をステージングする
git status: gitレポジトリの状態を確認
git commit -m "initinal commit": コメント付きでプッシュ
git remote add origin <url>: local な git repository を、github の remote repository に追加して、origin と名付ける。
git branch -M main: current repository を main に renameする。
git push -u origin main: remote repository の origin に、local repository の main branch を push する。-u をつけると、以降はこのコマンドを git push と省略可能。
mainブランチで大元のコードができたら
git switch -c <branch-name>
git branch

# 変更を加える

git status
git add -A
git status
git commit -m "modify some codes"

git switch main
git merge <branch-name>
git branch -d <branch-name> (任意)

git push
git switch -c <branch-name>: <branch-name> という branch を作成して移動。
git branch: branch 一覧と、現在の branch を確認。
git merge <branch-name>: 現在の branch と、<branch-name>を merge する。
git branch -d <branch-name>: <branch-name> を削除(任意)
git push: git push -u origin main の省略形
まとめ
gitの操作は間違えるとかなり重大なので、自分なりの方法を覚え書きとしてまとめました。自分は正直適当なのであまり参考にしないほうがいいと思います。
ハッシュマップ・辞書 - hashmap, dictionary (Python)
はじめに
今回はpythonにおけるハッシュマップについて解説します。コードの処理時間を改善するために不可欠な概念で、配列の検索時間などを向上させることができます。
ハッシュマップとは
pythonでは、辞書やハッシュテーブルとしても知られるもので、一意的なキー(key)と値(value)のペアでデータが格納されるデータ構造のことです。
ハッシュマップはデータ構造の一般的な概念を指していて、
辞書はハッシュマップという概念を(pythonで)実際に実装したものと考えればよいです。
ハッシュマップの解説
基本構造
person = {
    'name': 'John Doe',
    'age':  30,
    'city': 'New York'
}

print(person['name'])  # Output: John Doe
del person['city']
ハッシュマップは、(key): (value), といった形式で要素を書き連ねます。
キーは配列のインデックスのように扱うことができます。
キーと値のペアを削除する際は del を用いて削除できます。
辞書内包表記 (dictionary comprehension)
squares = {x: x**2 for x in range(1,  6)}
print(squares)  # Output: {1:  1,  2:  4,  3:  9,  4:  16,  5:  25}
辞書内包表記とは、pythonの辞書を簡潔に生成するための記法です。上の例では、1から6の反復処理をキーと値に対して行うことで、5つのデータを持つ辞書を一行で生成しています。
入れ子辞書 (nested dictionaries)
bookshelf = {
    'Book1': {'author': 'Author1', 'year':  2001},
    'Book2': {'author': 'Author2', 'year':  2005},
    'Book3': {'author': 'Author3', 'year':  2010}
}

print(bookshelf['Book1']['author'])  # Output: Author1
bookshelf['Book4'] = {'author': 'Author4', 'year':  2015}
入れ子辞書とは、辞書の値にさらに辞書が入った多段階の辞書のことです。上の例のように、出力したり追加することができます。
ハッシュマップを使う利点
検索速度が速い
ハッシュマップでは、ハッシュ関数を用いてキーと値の位置関係をマッピングしているため、データ数にかかわらずO(1)の定数時間で検索できます。
文字などの出現頻度を数える処理で有用
文字列や単語の出現頻度を数える(Frequency counting)でハッシュマップを使うと、検索速度が速いだけでなく、文字列をkeyに、頻度をvalueに設定してマッピングするだけで実装可能なため、コードがシンプルに書けます。また、ハッシュマップにデータを分散配置できるためメモリ効率が良いです。
多様なデータ型を扱える
keyもvalueも様々な型の値を設定することができます。
まとめ
今回はpythonにおけるハッシュマップ・辞書について解説しました。ハッシュマップが有用なのは、ハッシュ関数によってデータをメモリに分散配置して効率的に処理できる点にあるということがわかります。
英検1級一次試験突破記(勉強法も紹介)
はじめに
1月の下旬に2023年度第3回の実用英語技能検定1級の一次試験を受けて無事に(まぐれで)突破したので記録しておきます。一発で突破できました、やったね。
再来週二次試験です、ぴえん。
前提
私は海外に一度も行ったことがない、英語を始めたのは中学生からの日本人です。現在理系の大学1年生です。
私と似た境遇であれば、少しは参考になるかもしれません。
帰国子女の方や留学経験のある方は参考にならないかもです。
成績
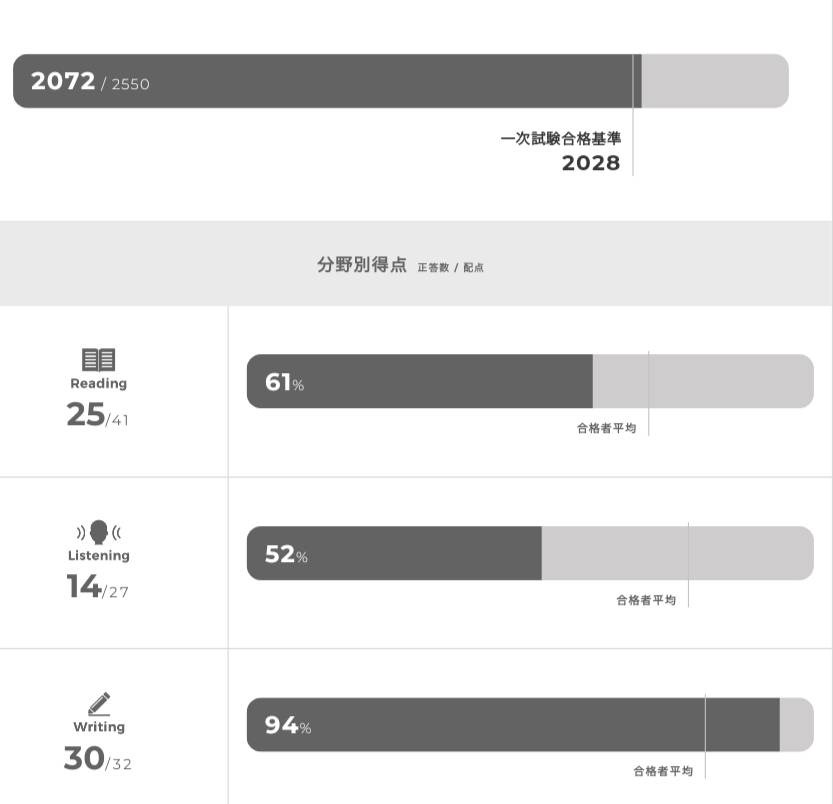
大問別の得点(括弧内は目標得点)
Reading
1. 11 / 25 (15)
2. 4 / 6 (5)
3. 8 / 10 (9)
Listening
1. 5 / 10 (7)
2. 4 / 10 (7)
3. 4 / 5 (4)
4. 1 / 2 (1)
Writing
94% (70%)
分析
Readingでちょい崩壊、Listeningで大崩壊、Writingで神のご加護の結果、合格できました。
語彙は、私にとっては運ゲーなのでノーコメです。
長文読解は、過去問より少し下振れたので悔しいです。リスニングで崩壊する可能性があったので(実際崩壊しました)、稼ぎたいパートでした。
Listeningは、過去問で波が激しかったので崩壊することは予想していました。Readingは結構安定していたので、Listening次第で合否が決まるだろう、という感じでした。
Writingは、誰にも添削してもらったことがなかったので不安でしたが、一級レベルの語彙を使う、正しい文法、繰り返しを避ける、論理的な文章を書く、ということだけを意識して練習通り書きました。
勉強法
まず英検1級の雰囲気を感じるために、DAILY30日間 英検1級 集中ゼミ 6訂版 (旺文社英検書) という参考書をやりました。とてもわかりやすくておすすめです。(実力のある方は飛ばしてやらなくてよいです)
語彙
運ゲーだと言いつつも、単語帳はやっていました。
使った単語帳は、
【音声アプリ対応】英検1級 文で覚える単熟語 4訂版 (旺文社英検書)
です。文章と英単語を結びつけて覚えるタイプの単語帳です。
長所はリーディング対策になって内容も面白い所で、短所は語彙問題より単語レベルが低く単語数が物足りない部分です。
正直語彙問題だけ明らかに難しくてコスパ悪かったので、気休め程度の対策です。前述の単語帳はむしろ読解対策に役に立ちました。
長文読解
前述の参考書と単語帳で練習しつつ、過去問ではスピードを意識して練習しました。解き終わったらわからなかった単語にマーカーを引いて、単語帳代わりにしていました(おすすめです)。
練習するときに意識したことは、読んでいるときに常に頭の中で話の内容を整理することです。選択肢は消去法で選んでいくので違うものを確実に見極める能力だけを強化しました。
リスニング
とにかくたくさん聞いていました(この無鉄砲さが崩壊の原因かも)。過去問を解く際は、聞き取れなかった部分を何度も真似して音読してみると聞き取れるようになるかもという気持ちで勉強してました。
あと、集中力で大きく点数に差が出るので、毎日問題を解いて感覚を失わないことや、調子が悪いときにあえてリスニングをやったりしてました。
ライティング
大体15回くらい練習しました。自分のリーディング速度的に、ライティングには25分から30分くらいしか使うことができなかったので、25分間で毎回練習してました(本番は30分使えました)。
基本的には、一つのトピックに対して賛成か反対かを示して、理由を3つ付け加えるという形が一般的だと思います。理由が思いつかないという方は、具体例から考えてみるといいと思います。その具体例を一般化して理由にすれば、理由と根拠(具体例)がセットで作れるのでお勧めのやり方です。
対策のコツは、ひたすら練習することです。書くスピードも結構重要になってくるので、まずはライティングに慣れるということが重要です。
まとめ
今回は先月受けた英検1級一次試験に突破したので、その記録と感想をまとめました。再来週は二次試験なので、ひたすら練習して気合いで合格したいと思います。
これから英検を受ける皆さんの合格もお祈りしています。
モジュール - modules(Fortran 第9回)
はじめに
第9回はモジュールです。
ひとまず、Fortranの内容は今回で終了です。サブグループの内容がわかっていれば、さほど難しくありません。
モジュールとは
モジュールとは、変数や手続き(内部ルーチン)などの様々な要素をひとまとめにしたものでです。モジュールを使うことによって、カプセル化やデータの共有を行うことができます。また、モジュール間では同じ名前の要素が作成できるため、名前空間の切り分けにも利用できます。
モジュールの解説
以下の具体例で示しているように、モジュールは外部ルーチンのようにmain programの外部に記述します。手続き(サブルーチン)を記述する際は、モジュール内部でcontainsして内部ルーチン(内部関数)として記述します。main programでモジュールの要素を利用する場合は、main programの冒頭にuse (モジュール名)でモジュールを利用できるようにしておきます。
具体例(モジュール)
! Module definition
module BasicCalculation
    implicit none
    private ! All variables and procedures are private by default

    ! Public constants and parameters
    integer, parameter :: VERSION =   1

    ! Public procedures
    public :: add, subtract

contains
    ! Function to add two integers
    pure function add(a, b) result(r)
        integer, intent(in) :: a, b
        integer :: r
        r = a + b
    end function add

    ! Subroutine to subtract two integers
    subroutine subtract(a, b, difference)
        integer, intent(in) :: a, b
        integer, intent(out) :: difference
        difference = a - b
    end subroutine subtract
end module BasicCalculation

! Program that uses the BasicCalculation module
program CalculationProgram
    use BasicCalculation
    implicit none

    integer :: num1, num2, sum, diff

    num1 =   5
    num2 =   3

    ! Use the add function from the module
    sum = add(num1, num2)
    print *, 'Sum: ', sum

    ! Use the subtract subroutine from the module
    call subtract(num1, num2, diff)
    print *, 'Difference: ', diff
end program CalculationProgram
まとめ
第9回はモジュールについて解説しました。
このページでは、モジュール自体の概念が理解しやすいように、単純な例しか扱っていないので、自分でコードを書いてみたり、ネットに転がっているコードを読んでみたりして理解を深めましょう。
注意
このページは大学のFortranの授業の予習で書いています。
直観的な理解をメモしているだけなので、厳密なところでは誤りがあるかもしれません。
内部ルーチン・内部関数 - internal routines, internal functions(Fortran 第8回)
はじめに
第8回は内部ルーチン・内部関数です。
第7回でやった外部ルーチン・外部関数と似ている部分あるので、サクッと解説していきます。
内部ルーチンとは
内部ルーチンとは、main programやほかのサブルーチン内で定義されるサブルーチンのこと。呼び出しは内部ルーチンが定義されたプログラムからのみ可能です。
内部関数とは
内部関数とは、main programやほかのサブルーチン内で定義される関数のこと、呼び出しは内部ルーチンと同様。
内部ルーチンは手続き的な処理を行うのに対し、内部関数は入力された値に対して何らかの計算をして出力するという特徴があります。(サブルーチンと関数の違いに由来しています)
解説
内部ルーチン、内部関数を記述する前にcontainsと記述します
具体例1(内部ルーチン)
program main_program
    implicit none
    real :: num1, num2, sum

    num1 =  3.0
    num2 =  4.0

    ! Call the internal subroutine to add two numbers
    call add_numbers(num1, num2, sum)
    print *, 'The sum of ', num1, ' and ', num2, ' is ', sum

contains
    ! Internal subroutine to add two numbers
    subroutine add_numbers(x, y, s)
        real, intent(in) :: x, y
        real, intent(out) :: s
        s = x + y
    end subroutine add_numbers
end program main_program
具体例2(内部関数)
program main_program
    implicit none
    real :: a, b, c
    real :: result

    a =  3.0
    b =  4.0

    ! Call the internal function to calculate the area of a triangle
    result = triangle_area(a, b)
    print *, 'The area of the triangle is: ', result

contains
    ! Internal function to calculate the area of a triangle
    function triangle_area(base, height) result(area)
        real, intent(in) :: base, height
        real :: area
        area =  0.5 * base * height
    end function triangle_area
end program main_program
疑問点
「外部ルーチンと内部ルーチンの使い分けの基準は?」
いろいろな基準で考えることができます。
再利用性の観点から、外部ルーチンはどこからでも呼び出せるのに対し、内部ルーチンは定義したサブルーチン内からしか呼び出せないので呼び出し元を限定できます。
コードの構造の観点から、外部ルーチンは分割する傾向、内部ルーチンは階層化する傾向があります。
外部ルーチンは、main programに実装の内容を記述しないので、カプセル化が可能です。
内部ルーチンは、呼び出し元のプログラムの変数や状態を利用する場合に適切でしょう。
まとめ
今回は内部ルーチン・内部関数の解説と、外部ルーチンとの使い分けについて解説しました。個人的には、関数を階層化するとコードが読みにくくなるので、できれば外部関数を使いたいと思いました。
第9回はモジュールです。
注意
このページは大学のFortranの授業の予習で書いています。
直観的な理解をメモしているだけなので、厳密なところでは誤りがあるかもしれません。
